
起因
最近在做自己网站的内容保护,顺手拿一个行业媒体(XX News)做对照测试。它把长文做成了会员内容:
- 文章页面上游客只能看到开头的引导段;
- 下面是一段被模糊处理的正文(视觉上像被「糊掉」的段落);
- 再往下是「加入会员 / 已有账号?登录」的转化盒。
我用游客身份(不带 cookie、没有账号)抓了它的页面 HTML,又抓了它的 WordPress REST API,两边拿到的正文长度差了近 4 倍:
| 入口 | 游客实际拿到的正文字数 |
|---|---|
| 文章页 HTML | 免费引导段 27 词 + 模糊钩子 72 词 ≈ 99 词 |
/wp-json/wp/v2/posts/623890 |
384 词(它自己的结构化数据里声明全文 393 词) |
结论很直白:它在页面上认真做了付费墙,但 WordPress 默认的 REST 接口把全文原样送了出来。
一、9 项探测:它到底开着几扇门
| 探测项 | 结果 | 说明什么 |
|---|---|---|
/wp-json/ 根 |
200,公开列出所有 namespace | REST 整片敞开 |
/wp-json/wp/v2/users |
200,作者名、slug、头像哈希、分页全给 | 典型的「没人管过 REST」特征 |
/wp-json/wp/v2/media、/pages |
均 200 | 不是只放开 posts,是整片没管 |
| REST 响应头 | X-Robots-Tag: noindex |
只阻止搜索引擎收录 API 结果,对采集器直接抓取毫无阻挡 |
xmlrpc.php |
403 | 有人做过安全加固 —— 说明加固清单里有别的门,独独漏了 REST |
| 托管平台痕迹 | wpe/cache-plugin/v1 → WP Engine |
平台层默认加固(403 大概率来自平台,不是站方主动配的) |
robots.txt |
Crawl-delay: 10 + Disallow:(空) |
有照顾爬虫压力的意识,却完全没考虑过 /wp-json/ |
| 付费墙 SEO | 无 isAccessibleForFree、无 hasPart |
连付费墙的标准 SEO 声明都没做 |
| 墙的实现 | Elementor 自定义模糊块 + user-select: auto |
商业上认真收费,细节上没打磨 |
最要紧的一行数据是批量接口:
GET /wp-json/wp/v2/posts?per_page=100&_fields=id,slug,content
→ 200,一次返回 100 篇全文,共 34,578 词(平均 346 词/篇)
→ 响应头 X-WP-Total: 17862 篇
也就是说,任何人(包括 AI 爬虫)只要翻页拉一遍这个接口,就能把它全部 1.7 万篇文章的正文整站搬走,而页面上那些模糊块和登录提示完全不起作用。
二、这是疏忽,还是故意留的免费通道?
我的判断是:几乎可以确定是疏忽,理由有三条。
1. 商业逻辑自相矛盾
页面上到处在卖订阅(30p/天起)。没有出版商会一边卖会员,一边把 1.7 万篇全文无认证公开——尤其是现在 AI 爬虫抓到全文后会直接生成摘要,替代掉用户来站阅读这件事本身。
2. 它不是「开放 API」的姿态,而是「完全没配置」的姿态
一个有意开放的免费通道,通常会留下痕迹:robots.txt 里 Allow: /wp-json/、有开发者文档页、有限速或字段白名单。现在是 users / media / pages 一起裸奔,这是「没人审计过」的味道。
3. 加固清单漏项
xmlrpc.php 已经被 403 挡住,说明有人列过安全清单。但 REST 没进清单——这正是「疏忽」最典型的形态。
三、技术根因:两条平行的输出路径
这件事的本质,是很多 WordPress 站长都会踩的坑:
flowchart LR
    A[数据库里的 post_content<br/>完整正文] --> B[路径 1: 主题渲染]
    A --> C[路径 2: REST API]
    B --> D[the_content 过滤器<br/>会员插件在这里拦截]
    D --> E[页面输出: 只给引导段]
    C --> F[content.rendered<br/>默认不过会员过滤]
    F --> G[API 输出: 全文]
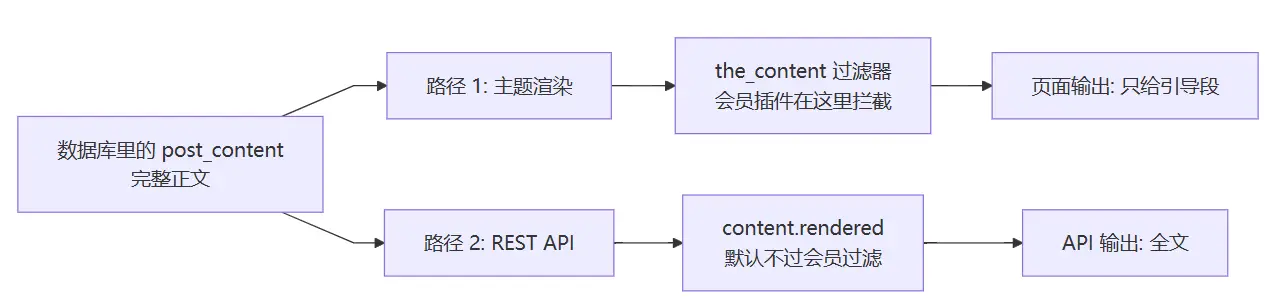
会员插件(Paid Memberships Pro、以及绝大多数同类插件)的限制都挂在 the_content 过滤器上,那是主题渲染层。而 /wp-json/wp/v2/posts 走的是另一条路径,默认不经过这个过滤器,所以数据库里的原文照样输出。
一句话总结:
装了会员插件 ≠ 内容被保护。它只保护了「页面」这一个出口。
四、内容保护的四扇门(自查清单)
单有「服务端截断」是不够的,必须把所有平行输出通道一起关掉:
| 出口 | 风险 | 处理方式 |
|---|---|---|
| REST API | 全文 + 作者 + 媒体全泄漏 | 游客直接 401,只放行必要的 oembed |
| RSS / feed | 很多主题在 feed 里输出全文 | 直接 410,或改成只输出摘要 |
| oEmbed | 可能带出正文片段 | 白名单只留 oembed/1.0 |
?amp= / 搜索结果页 / ?s= |
绕过页面模板的平行渲染 | 回归测试时逐一验证 |
xmlrpc.php |
老接口,可列举 / 发布 | 直接 403 |
我自己站的 REST 封锁就是这么做的(示意):
add_filter('rest_authentication_errors', function ($result) {
    if (!empty($result) || is_user_logged_in()) {
        return $result;
    }
    if (is_wp_error($result)) {
        return $result;
    }
    // 只放行 oembed(只给嵌入信息,不含正文)
    $route = $GLOBALS['wp']->query_vars['rest_route'] ?? '';
    if (strpos($route, '/oembed/1.0') === 0) {
        return $result;
    }
    return new WP_Error(
        'rest_login_required',
        '请登录后访问 API。',
        ['status' => 401]
    );
}, 99);
feed 则挂 template_redirect 更干净(那时还没有任何输出,状态码不会被覆盖):
add_action('template_redirect', function () {
    if (is_feed()) {
        wp_die('本站不提供 Feed。', 'Feed Disabled', ['response' => 410]);
    }
});
五、怎么验证自己的站有没有漏
改完代码别只看文章页,要用「字数对比」验证。以任意一篇文章为例:
# 1. 游客从页面能拿到的正文字数
curl -s https://yoursite.com/your-post/ | sed 's/<[^>]*>//g' | wc -w

# 2. REST 接口给游客的正文字数(如果返回 401 就是关好了)
curl -s "https://yoursite.com/wp-json/wp/v2/posts?slug=your-post" \
  | jq -r '.[0].content.rendered' | sed 's/<[^>]*>//g' | wc -w

# 3. feed 应该不是 200
curl -s -o /dev/null -w "%{http_code}\n" https://yoursite.com/feed/
判断标准很简单:
- 页面字数 < REST 字数 → 有泄漏,REST 没关住;
- 两个数字接近 → 说明页面本身也没截断,墙没生效;
- 页面 401/410/403,或 REST 报错 → 关好了。
PowerShell 版本:
(iwr https://yoursite.com/your-post/).Content -replace '<[^>]*>','' -split '\s+' | Measure-Object -Word
六、小结
这次对照测试给了我三条可以直接用的结论:
- 内容保护的漏洞通常不在「墙」本身,而在「墙外的平行出口」:REST、feed、oembed、AMP、搜索页。只堵页面等于没堵。
- WordPress 会员插件默认不保护 REST API,这是行业里最普遍的漏洞——不是那一家站的个案。
- 验证要数字化:不要凭肉眼、凭感觉,要比「页面字数 vs 各入口字数」,一处不符就是漏。
对一个靠内容吃饭的站来说,最坏的情况不是「被抄了几段」,而是「整站 1.7 万篇被一次性搬走,而自己还以为付费墙在生效」。
本文章永久链接: WordPress 会员站的隐形漏洞:付费墙挡住了人,却挡不住 API