
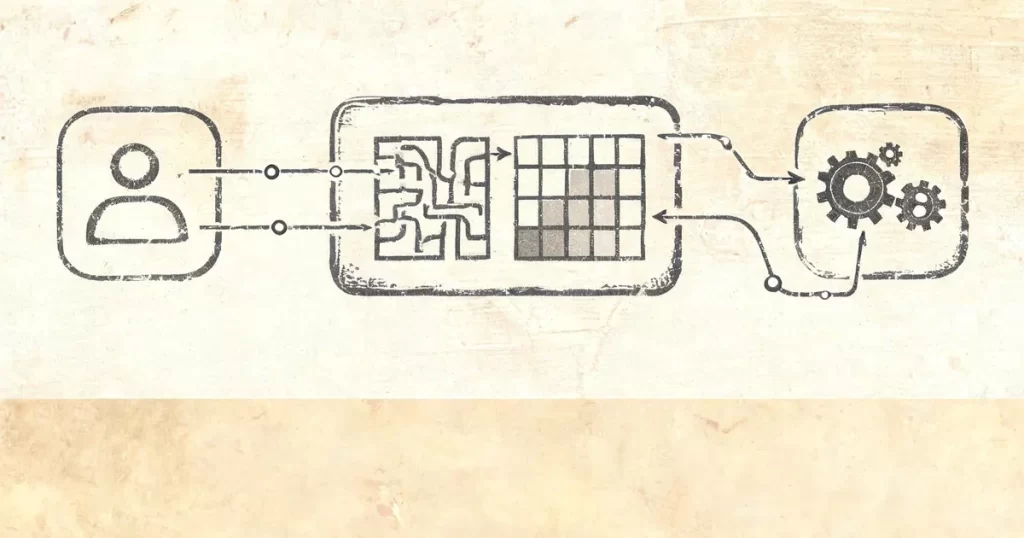
给自建的单词复习工具接了 edge-tts 朗读之后,我一直有个没说清的疑问:这段语音到底是我服务器合成出来的,还是微软合成好回传给我的? 如果是后者,我这条链路又到底吃多少流量?
顺手把代码翻了一遍,结论比想象的省心。
一句话答案
神经网络推理在微软那台机器上跑。我的服务器只是个「会缓存的代理」:连上去、收 mp3、落盘、转发。
它不加载任何 TTS 模型,CPU 只用来收发字节和写文件。
一、链路拆开看:是三段,不是一段
sequenceDiagram
    participant B as 手机浏览器
    participant S as 自己的服务器 (Python)
    participant M as 微软朗读后端
    B->>S: POST /api/tts {text}
    S->>S: 查本地音频缓存
    note over S: 命中 → 直接读盘返回,本节结束
    S->>M: WSS 发 SSML(纯文本)
    M-->>S: 二进制帧流(mp3)
    S->>S: 边收边写盘
    S-->>B: mp3(HTTP 响应)
代码层面的证据很直白:tts.synthesize() 里打开一个文件,然后遍历 comm.stream(),把每个 item["data"] 直接写盘 ——
async def _synth_async(text: str, voice: str, rate: str, out_path: str) -> None:
    import edge_tts
    with open(out_path, "wb") as fh:
        for chunk in _split(text):
            comm = edge_tts.Communicate(chunk, voice, rate=rate)
            async for item in comm.stream():
                if item.get("type") == "audio" and item.get("data"):
                    fh.write(item["data"])     # ← 这是微软推回来的 mp3 字节
拿到的是微软推回来的音频字节流,本地只是「接住」。真正的合成端点是 Edge 浏览器「大声朗读」用的那个 WebSocket 接口:
wss://speech.platform.bing.com/consumer/speech/synthesize/readaloud/edge/v1
    ?TrustedClientToken=<edge-tts 库里写死的公开常量>
不是 Azure 语音服务 —— 不需要账号、不需要 Key、也不按量计费。
二、那能不能把这活挪到浏览器里做?
理论上可以。那个端点就是个普通 WebSocket 协议,浏览器有 WebSocket,而它需要的参数恰好都放在 query string 里(浏览器不能自定义请求头这件事因此不成问题)。协议只有三步:
- 握手:query 带
TrustedClientToken和Sec-MS-GEC指纹; - 先发一个
speech.config,告诉它要audio-24khz-48kbitrate-mono-mp3; - 再发一句 SSML,然后一路收二进制帧;收到文本帧
Path:turn.end就是结束。
示意实现(细节需对照 edge_tts/communicate.py 校准):
const TRUSTED = '<公开的 client token>';
const WIN_EPOCH = 11644473600;            // 1601-01-01 → Unix

// 微软要的客户端指纹:SHA256(对齐到 5 分钟的 FILETIME ticks + token)
async function secMsGec() {
  let ticks = Math.floor(Date.now() / 1000) + WIN_EPOCH;
  ticks -= ticks % 300;
  // ⚠️ Python 里这是大整数;JS 的 Number 在这里会丢精度(约 1.3e16 > 2^53)
  return sha256Hex(`${BigInt(ticks) * 10000000n}${TRUSTED}`).toUpperCase();
}

async function synthInBrowser(text, voice = 'en-US-AriaNeural') {
  const ws = new WebSocket('wss://speech.platform.bing.com/consumer/speech/'
    + 'synthesize/readaloud/edge/v1'
    + `?TrustedClientToken=${TRUSTED}&Sec-MS-GEC=${await secMsGec()}`);
  ws.binaryType = 'arraybuffer';
  const parts = [];
  // ... onopen 发 speech.config + SSML,onmessage 收帧,末尾拼成 Blob
}
看着诱人(省掉服务器出站),但真去做有四个坑:
| 障碍 | 说明 |
|---|---|
| 非安全上下文 | 站点跑在 http://<服务器IP>/ 时,isSecureContext === false → crypto.subtle 和 crypto.randomUUID 都不可用,而算指纹要 SHA-256,得自带一份纯 JS 实现。上 HTTPS 才能自然解决 |
| 依赖浏览器时钟 | 指纹是按当前时间对齐 5 分钟算的,用户手机时间偏差大就直接被拒。服务器端的时钟在自己手里,可控得多 |
| 微软侧风控 | token 和算法跑在客户端就等于对所有人公开。对方一旦加白名单或换版本,只能等用户刷新页面才生效;服务端改一行就够了 |
| 丢掉服务器缓存 | 现在同一段文本全校验、所有设备只合成一次;挪到浏览器后每个浏览器各合成一遍 —— 省了自己的出站,却把「读盘毫秒返回」变成「实时等合成」 |
顺带说一句:项目里其实已经有一条「浏览器直连」的路 —— 接口失败时前端会回退到浏览器自带的 speechSynthesis。在 Edge 桌面版上它调的就是微软的在线自然语音,同样不经过我的服务器,只是音色挑不了、语速控制弱,手机上音质明显更差。
三、算账:一次真的只花 50 KB,不是 100 KB
容易算错的地方在于把「来回」当成两笔支出。拆开看:
| 段 | 方向 | 大小 | 算谁的量 |
|---|---|---|---|
| 服务器 → 微软 | 上行 | 几百字节 ~ 2 KB(就一句 SSML 文本) | 忽略不计 |
| 微软 → 服务器 | 下行(入站) | ~50 KB(mp3 本体) | 出站才计费,这段不计 |
| 服务器 → 手机 | 出站 | ~50 KB(同一个 mp3) | ✅ 只有这段扣流量 |
所以口径是 一次新合成 ≈ 50 KB 出站(mp3 是 48 kbps 单声道,约 6 KB/秒,50 KB 大致对应 8~10 秒语音)。上行几乎为零,中间那段对计费无影响。
而且这 50 KB 是上界:
- 服务器端先按
音色 + 语速 + 文本的哈希查本地缓存,命中就读盘返回,根本不会去连微软; - 浏览器侧还有一周的 HTTP 缓存,前端内存里也记着一份 —— 同一台设备重复听是零请求;
- 真正产生流量的,只有「这段文本第一次被任何设备朗读」那一次。
$$\text{月出站流量} \approx \text{每月新合成段数} \times 50\ \text{KB}$$
| 每月新合成 | 出站流量 |
|---|---|
| 1,000 段 | 50 MB |
| 10,000 段 | 500 MB |
| 100,000 段 | 5 GB |
就算一个月听一万段全新内容,也只吃掉 0.5 GB —— 放在常见的几百 GB 月流量包里,这个通道基本可以当作不存在。
四、结论
- 合成在微软,不在我这儿。 我的服务器是缓存 + 转发,不是算力。
- 不用为流量焦虑。 一次新合成约 50 KB 出站,重复听为零;月账按 MB 级算,不是 GB 级。
- 不打算改成浏览器直连。 省下的那点流量,换不回服务器端缓存、可控时钟和「改一行就生效」的余地 —— 保留服务端为主通道、浏览器语音当兜底,是更稳的组合。
- 何况这套工具目前基本只有我自己在用,用户几乎为零 —— 连「优化流量」这个议题现在都排不上优先级。
先把功能做好,等真有人用了,再回头算这笔账也不迟。
本文章永久链接: Edge TTS 到底谁在合成?顺便算清这点流量要不要在意